FAIR-Datenprinzipien
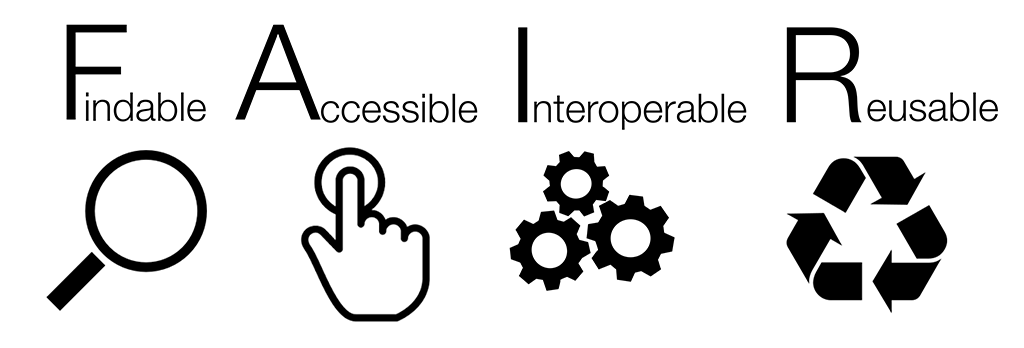
Bildnachweis: SangyaPundir, CC BY-SA 4.0.
Einleitung
Die FAIR-Datenprinzipien wurden veröffentlicht, nachdem sie 2014 auf dem Lorentz-Workshop definiert worden waren. Diese Grundsätze dienen sowohl denjenigen, die Daten veröffentlichen, z. B. Forschern, als auch denjenigen, die Daten aufbewahren, z. B. Repositorien oder Archivdienstleistern, als Leitlinien. Dies ist ein wichtiger Unterschied, der verdeutlicht, dass die Daten eines Forschers nur so FAIR sein können wie die ihm zur Verfügung stehende Infrastruktur und die ihm angebotenen Dienste.
Mit Blick auf das langfristige Ziel, wissenschaftliche Daten für andere wiederverwendbar zu machen, indem in der ständig wachsenden Datenflut aus der Forschung eine systematische Ordnung geschaffen wird, legen die FAIR-Datenprinzipien einen starken Schwerpunkt auf maschinenlesbare (Meta-)Daten. Während auch Menschen in der Lage sein müssen, die veröffentlichten Datensätze zu finden und zu verstehen, wird es die Aufgabe der Computer sein, große Datenmengen zu durchforsten und zu ermitteln, welche Datensätze für den beabsichtigten Zweck relevant sind und wie sie wiederverwendet werden können.
Die Wiederverwendung sorgfältig aufbereiteter Forschungsdaten erleichtert Forschern die Arbeit und ermöglicht es ihnen, auf früheren Forschungsergebnissen aufzubauen. Darüber hinaus bietet die Wiederverwendung von Daten die Möglichkeit, große Datenbestände für Anwendungen im Bereich des maschinellen Lernens auszuschöpfen. So könnten beispielsweise große Mengen an Daten zur chemischen Synthese zur virtuellen Entwicklung neuer Synthesemethoden oder zur Entdeckung neuer Verbindungen führen.
In der Chemie bezeichnet dies die Hinterlegung kristallographischer Daten in einem standardisierten Dateiformat (CIF) in einem Repositorium wie der Cambridge Structural Database (CSD) beim Cambridge Crystallographic Data Centre (CCDC) oder der Inorganic Crystal Structure Database (ICSD) beim FIZ Karlsruhe, wie sie von vielen führenden Fachzeitschriften der chemischen Fachwelt gefordert wird, das wichtigste Beispiel für die Umsetzung der FAIR-Datenprinzipien in der Praxis. Um den Anwendungsbereich solcher Standards zu erweitern, arbeitet NFDI4Chem daran, eine Infrastruktur für FAIR-Daten in Deutschland aufzubauen und Forscher darin zu schulen, die verfügbare Infrastruktur zu nutzen, um sicherzustellen, dass ihre Daten so FAIR wie möglich sind.
Im Folgenden beantworten wir die Fragen: Was macht Daten FAIR? Was müssen Forscher und Anbieter von Datenaufbewahrungsdiensten beachten?
Auffindbar
Forscher – und die Computer, die für sie arbeiten – müssen in der Lage sein, Datensätze zu finden, um diese wiederverwenden zu können. Daher werden in der ersten Leitlinie der FAIR-Datenprinzipien Methoden beschrieben, mit denen die Auffindbarkeit eines Datensatzes gewährleistet werden kann.
F1. (Meta-)Daten erhalten eine global eindeutige und dauerhafte Kennung
Ein weltweit eindeutiger persistenter Identifikator (PID) hilft sowohl Maschinen als auch Menschen dabei, die Daten überhaupt erst zu finden. Diese PIDs sind für die Forschung unverzichtbar, da sie die Verfügbarkeit der zugehörigen Ressource – in diesem Fall eines Datensatzes – gewährleisten. Die Registrierungsdienste, die diese Identifikatoren bereitstellen, sorgen dafür, dass die Verknüpfung zur Ressource aufrechterhalten bleibt, wodurch tote Links vermieden werden.
Ein gängiges Beispiel für eine zitierfähige PID ist der Digital Object Identifier, kurz DOI. Wie bei vielen Fachzeitschriften vergeben auch wissenschaftliche Datenrepositorien häufig automatisch eine DOI. So vergeben beispielsweise sowohl die Cambridge Structural Database (CSD) als auch das Chemotion Repository jedem hinterlegten Datensatz eine DOI. Forscher sollten diese Möglichkeit bei der Suche nach einem geeigneten Repositorium (z. B. bei re3data) berücksichtigen, während Repositorien diesen Service anbieten sollten.
F2. Die Daten werden mit umfangreichen Metadaten beschrieben (definiert durch R1 unten)
Daten müssen ausreichend beschrieben werden, damit sie sowohl auffindbar als auch wiederverwendbar sind. Daher liegt der Schwerpunkt hier darauf, die (Meta-)Daten durch die Verwendung von „Rich Discovery“ Metadaten in einem standardisierten Format auffindbar zu machen und es Computern und Menschen zu ermöglichen, den Inhalt des Datensatzes schnell zu erfassen. Dies ist ein wesentlicher Bestandteil der Vielzahl von Metadaten, die in R1 weiter unten beschrieben werden. Diese Informationen können unter anderem Folgendes umfassen:
- den Kontext dazu, was der Datensatz ist, wie er erstellt wurde und wie er interpretiert werden kann,
- die Datenqualität,
- Lizenz- und (Wieder-)Verwendungsvereinbarungen,
- welche weiteren Daten damit in Zusammenhang stehen könnten (über deren PID verknüpft) und
- zugehörige Zeitschriftenartikel und deren DOI.
Repositorien sollten ein ausfüllbares Anwendungsprofil bereitstellen, das es Forschern ermöglicht, umfassende und präzise Angaben zu ihren hinterlegten Datensätzen zu machen. So nutzt beispielsweise das Chemotion Repository unter anderem RADAR4Chem sowie das Datacite-Metadatenschema zur Erstellung seines Anwendungsprofils – ein Schema, das speziell für die Veröffentlichung und Zitierung von Forschungsdaten entwickelt wurde. Dazu gehört eine Auswahl an obligatorischen, empfohlenen und optionalen Metadaten-Eigenschaften, die eine umfassende Beschreibung des hinterlegten Datensatzes ermöglichen. Wer Daten veröffentlicht, sollte stets bedenken: Je mehr Informationen bereitgestellt werden, desto besser.
F3. Metadaten enthalten klar und eindeutig die Kennung der Daten, die sie beschreiben
Während F1 die Vergabe einer Kennung vorschreibt, unterstreicht F3, wie wichtig es ist, diese Kennung in die Metadaten selbst aufzunehmen. Die Metadaten und der darin beschriebene Datensatz sind in der Regel separate Dateien. Durch die Aufnahme der Kennung in die Metadaten wird die Information direkt mit dem zugehörigen Datensatz verknüpft.
Außerdem darf der Datensatz nicht zusammen mit den Metadaten veröffentlicht werden. Bei unveröffentlichten archivierten Datensätzen kann die PID beispielsweise zu einer Möglichkeit (z. B. einer Landingpage) führen, die für die Daten Verantwortlichen zu kontaktieren, anstatt direkt zum Datensatz selbst. Forscher müssen sich dieser Bedeutung bewusst sein, während Repositorien nicht nur eine PID gemäß der obigen Beschreibung in F2 zuweisen müssen, sondern auch sicherstellen sollten, dass diese PID ein obligatorisches Merkmal der Metadaten ist.
F4. (Meta-)Daten werden in einer durchsuchbaren Ressource erfasst oder indexiert
Metadaten werden zur Erstellung von Indizes verwendet, wodurch Maschinen Datensätze effizient suchen und finden können. Damit dieser Vorgang erfolgreich abläuft, müssen die Metadaten vollständig sein, wie oben beschrieben. Repositorien sollten sicherstellen, dass die für einen hinterlegten Datensatz eingegebenen Metadaten in einem maschinenlesbaren Format vorliegen, um die Zuweisung von Indizes zu erleichtern.
Barrierefrei
„Zugänglich“ bedeutet, dass Menschen und Maschinen Anweisungen erhalten, wie sie an die Daten gelangen können. Es sei darauf hingewiesen, dass FAIR nicht gleichbedeutend mit „offen“ ist, wie in A1.2 näher erläutert wird.
A1. (Meta-)Daten können anhand ihrer Kennung unter Verwendung eines standardisierten Kommunikationsprotokolls abgerufen werden
Um den Zugriff auf Datensätze zu gewährleisten, werden persistente Identifikatoren wie DOIs empfohlen, die mit Standardverfahren aufgelöst werden können. Zu den gängigen Protokollen gehören HTTP(S) oder (S)FTP.
A1.1 Das Protokoll ist offen, kostenlos und universell umsetzbar.
Repositorien sollten ausschließlich Protokolle verwenden, die es jedem Computer ermöglichen, zumindest auf die Metadaten zuzugreifen. Dies bezieht sich nicht nur auf die Verwendung von Standard-Kommunikationsprotokollen, wie in [A1] (#a1) dargelegt, sondern diese Protokolle müssen zudem frei verfügbar und Open Source sein. Daher sollten proprietäre oder nicht standardisierte Protokolle vermieden werden.
A1.2 Das Protokoll sieht bei Bedarf ein Authentifizierungs- und Autorisierungsverfahren vor.
Gegebenenfalls müssen maschinenlesbare Protokolle vorhanden sein, die den Benutzer darauf hinweisen, dass er bestimmte Maßnahmen ergreifen muss (z. B. eine Anmeldung), um auf Daten zugreifen zu können. FAIR-Daten und offene Daten sind nicht dasselbe: Bei FAIR-Daten muss klar angegeben werden, wie auf die Daten zugegriffen werden kann – im Gegensatz dazu, dass jedem uneingeschränkter Zugriff gewährt wird. In Manuskripten wissenschaftlicher Artikel sollten diese Informationen in einer Erklärung zur Datenverfügbarkeit enthalten sein. Dies kann insbesondere bei sensiblen Daten von Bedeutung sein, bei denen beispielsweise personenbezogene Daten und/oder medizinische Informationen offengelegt werden könnten. Daher sollten Repositories auch eine Möglichkeit bieten, dass sich Benutzer (und ihre Computer) identifizieren können, damit ihnen Zugriffsrechte gewährt werden können.
A2. Metadaten sind zugänglich, auch wenn die Daten selbst nicht mehr verfügbar sind
Die Metadaten, die einen Datensatz beschreiben, sollten in einer separaten Datei gespeichert werden, damit sie auch dann noch verfügbar sind, wenn auf die Datensätze selbst nicht mehr zugegriffen werden kann. Probleme mit der Verfügbarkeit von Datensätzen sind in der Regel auf 1) die Kosten für die Pflege und Speicherung vollständiger Datensätze und 2) die Veralterung von Dateiformaten im Zuge der technologischen Weiterentwicklung zurückzuführen. Die Pflege von Metadatendateien ist kostengünstiger und einfacher und stellt sicher, dass zumindest Angaben wie Kontaktdaten weiterhin verfügbar bleiben. Diese Dateien sollten daher dauerhaft archiviert werden.
Ein Repository sollte einen klaren Notfallplan für die Speicherung von Metadaten vorsehen, falls der Dienst nicht mehr existiert, beispielsweise die Migration zu einem anderen Repository-Anbieter, wobei die Integrität des persistenten Identifikators gewährleistet sein muss.
Interoperabel
Daten müssen mit anderen Datensätzen zusammengeführt und/oder mit diesen verglichen werden, während Computer in der Lage sein müssen, die Informationen zu interpretieren und auszutauschen. Im Idealfall sind sie mit Standardanwendungen kompatibel und lassen sich somit in (automatisierte) Verarbeitungs- und Analyse-Workflows integrieren. Interoperabilität dient oft als Voraussetzung für Wiederverwendbarkeit, da sie die Kompatibilität zwischen verschiedenen Systemen gewährleistet.
I1. (Meta-)Daten nutzen eine formale, barrierefreie, gemeinsame und breit einsetzbare Sprache zur Wissensdarstellung
Maschinen müssen in der Lage sein, zu verstehen, wie Informationen ausgetauscht und interpretiert werden. Ähnlich wie beim Menschen trägt eine einheitliche und standardisierte Sprache zu diesem Verständnis bei. In der Chemie ist ein hervorragendes typisches Beispiel für einen solchen Standard zum Informationsaustausch die Kristallographische Information (CIF). Dieser Standard entspricht zudem den in I2 beschriebenen Aspekten, wonach bei einer bestimmten Analysemethode sichergestellt werden muss, dass die Daten und die zugehörigen Metadaten – zu denen in der Regel beispielsweise Messdetails gehören – einem vorgeschriebenen Format entsprechen. Dadurch wird sichergestellt, dass sowohl Menschen als auch Maschinen die Informationen erhalten, die sie zur Auswertung der Daten benötigen.
Insbesondere bei der Betrachtung von Metadaten hängt eine effektive und effiziente maschinelle Lesbarkeit in hohem Maße davon ab, ob es gelingt, Mehrdeutigkeiten zu reduzieren. Metadaten liefern Kontextinformationen zu Datensätzen. Maschinen müssen jedoch in der Lage sein, diesen Kontext zu interpretieren. Daher sollten die von den Repositorien gewählten strukturierten Schemata allgemein gültige Ontologien und kontrollierte Vokabulare enthalten, um Beziehungen zu definieren und Mehrdeutigkeiten zu vermeiden. Beispielsweise sollten chemiespezifische Repositorien so konzipiert sein, dass sie Ontologien wie die Chemical Methods Ontology (CHMO) oder die Chemical Information Ontology (CHEMINF) enthalten, um die bereitgestellten (Meta-)Daten genau zu beschreiben. Solche Ontologien sollten auf weit verbreiteten Datenmodellen basieren, beispielsweise dem „ “ Resource Description Framework (RDF).
I2. (Meta-)Daten verwenden Vokabulare, die den FAIR-Prinzipien entsprechen
Die verwendeten Vokabulare bzw. Ontologien sollten gut dokumentiert sein und sich anhand einer PID auflösen lassen. So ist beispielsweise das oben erwähnte CHMO auf GitHub öffentlich zugänglich.
I3. (Meta-)Daten enthalten qualifizierte Verweise auf andere (Meta-)Daten
Verwandte Datensätze sollten zuverlässig miteinander verknüpft werden, vorzugsweise über ihre PIDs. Dazu gehören alle früheren Versionen, Datensätze, die für die vollständige Nutzung und das Verständnis des aktuellen Datensatzes erforderlich sind, sowie Datensätze, auf denen der aktuelle Datensatz aufbaut. Diese Beziehung sollte zudem aussagekräftig beschrieben werden. Wenn beispielsweise der Datensatz X eine frühere Version des Datensatzes Y ist, würde er als solcher beschrieben werden und nicht einfach nur als verwandter oder zugehöriger Datensatz. Repositorien sollten eine Möglichkeit bieten, in ihren Metadaten auf andere Datensätze zu verweisen.
Wiederverwendbar
Viele der zuvor genannten Punkte führen zu einem zentralen Aspekt des Datenaustauschs: der Wiederverwendbarkeit von Daten. Datensätze müssen so beschrieben werden, dass der Nutzer leicht erkennen kann, wie und unter welchen Bedingungen die Daten wiederverwendet werden können.
R1. (Meta-)Daten werden anhand einer Vielzahl präziser und relevanter Attribute ausführlich beschrieben
Im Zusammenhang mit F2:
- Was der Datensatz enthält, einschließlich der Angabe, ob es sich um Rohdaten und/oder verarbeitete Daten handelt
- Wie die Daten verarbeitet wurden
- Wie die Daten wiederverwendet werden können
- Wer hat die Daten erstellt?
- Erstellungsdatum
- Variablennamen
- Verwendete Standardmethoden
- Umfang der Daten und des Projekts
- Laborbedingungen
- Gibt es Einschränkungen hinsichtlich der Daten?
- Für die Erfassung und Verarbeitung verwendete Software und Versionen.
Eine wichtige Informationsquelle für chemische Daten sind maschinenlesbare chemische Strukturen. Dies sollte im Datensatz und/oder in den Metadaten enthalten sein und hilft Computern dabei, bei ihren Abfragen die richtigen Daten zu finden.
Repositorien sollten Datenveröffentlichern die Möglichkeit bieten, vielfältige Informationen in ihre Metadaten aufzunehmen. Dazu gehört auch, dass Datenanbietern eine Vielzahl von optionalen und frei ausfüllbaren Feldern zur Verfügung gestellt wird, die sie ausfüllen können.
R1.1. (Meta-)Daten werden unter einer klaren und verständlichen Lizenz zur Datennutzung veröffentlicht
Die Metadaten sollten sowohl für Menschen als auch für Maschinen lesbare Nutzungsbedingungen enthalten, wie beispielsweise eine Lizenz. Creative Commons-Lizenzen werden häufig für wissenschaftliche Daten verwendet. re3data gibt an, ob ein Repositorium Forschern die Möglichkeit bietet, bei der Hinterlegung von Daten direkt eine Lizenz oder Nutzungsbedingungen auszuwählen. Repositorien sollten Forschern zumindest die Möglichkeit bieten, eine Lizenzdatei hinzuzufügen.
R1.2. (Meta-)Daten sind mit detaillierten Herkunftsangaben verknüpft
Einfach ausgedrückt: Metadaten umfassen alle relevanten historischen Informationen. Wenn der Datensatz mit anderen Datensätzen in Zusammenhang steht oder auf den Daten eines anderen Forschers basiert, sollten diese gemäß der Beschreibung in I3 über ihre PID verknüpft werden. Dazu gehört auch, die Arbeit anderer zu zitieren oder zu würdigen, wobei deren Lizenz- oder Nutzungsvereinbarungen ebenfalls zu berücksichtigen sind (siehe R1.1). Darüber hinaus sollten Metadaten maschinenlesbare Informationen darüber enthalten, wie die Daten erzeugt oder verarbeitet wurden.
R1.3. (Meta-)Daten entsprechen den domänenrelevanten Community-Standards
Da das Forschungsdatenmanagement und damit auch die Veröffentlichung von Daten in allen Forschungsbereichen immer mehr an Bedeutung gewinnen, werden sich in den einzelnen Fachgemeinschaften bewährte Verfahren herausbilden. Dies sollte Metadatenvorlagen für die ordnungsgemäße Dokumentation von Datensätzen umfassen, Angaben dazu, wie die Daten organisiert werden sollten, welche Vokabulare oder Ontologien zu verwenden sind sowie Dateiformate. NFDI4Chem arbeitet daran, Metadaten- und Datenstandards für die verschiedenen Fachgemeinschaften in der Chemie zu etablieren.
Soweit vorhanden, sollten die Community-Standards und bewährten Verfahren befolgt werden, wenn die Veröffentlichenden ihre Datensätze und die dazugehörigen Metadaten für die Veröffentlichung aufbereiten. Repositorien, insbesondere domänenspezifische Dienstanbieter, sollten sich an die von der Community festgelegten Standards halten, indem sie verlangen, dass Dateien und Metadaten den Formatvorgaben entsprechen.
Gegebenenfalls sollten Formatkonverter in den Metadaten des Datensatzes verlinkt werden.
Quellen und weitere Informationen
- FORCE 11: FAIR-Datenprinzipien
- Go-FAIR-Initiative: FAIR-Prinzipien
- TIB-Blog: Die FAIR-Datenprinzipien für Forschungsdaten
- FAIRsFAIR: Wie Sie Ihre Daten nach den FAIR-Prinzipien verwalten. Ein Handbuch für Lehre und Ausbildung an Hochschulen & Engelhardt et al. (Buchversion) & Gitbook-Version
- Checkliste: Wie FAIR sind Ihre Daten?
